Cùng với làn sóng ứng dụng AI tạo sinh, cụm từ "vector database" xuất hiện dày đặc trong các bài viết kỹ thuật và cả bản thuyết trình gọi vốn. Nhiều team vội vàng thêm một hệ cơ sở dữ liệu mới vào kiến trúc chỉ vì "làm AI thì phải có". Nhưng vector database thực chất là gì, giải quyết vấn đề nào, và liệu dự án của bạn có cần đến nó? Bài viết này giúp bạn trả lời những câu hỏi đó một cách thực tế.
Embedding: biến ý nghĩa thành con số
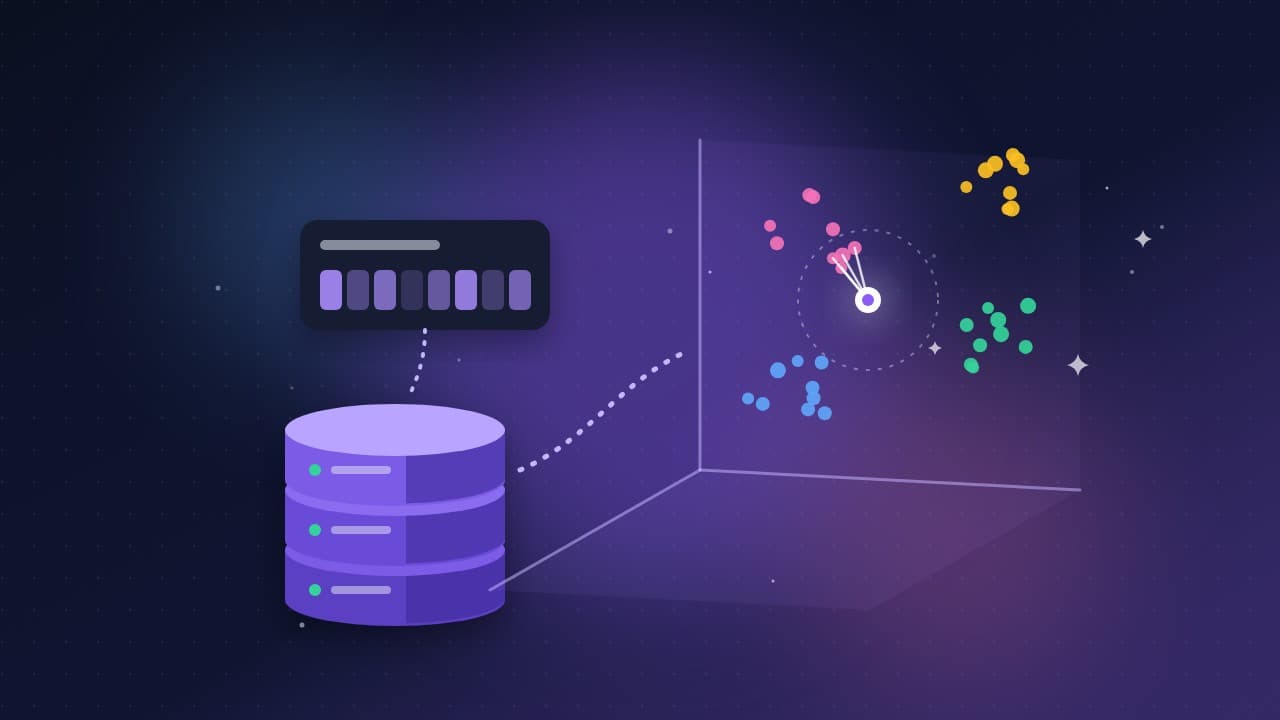
Để hiểu vector database, trước hết cần hiểu embedding. Embedding là một dãy số thực (vector), thường có vài trăm đến vài nghìn chiều, do một mô hình học máy tạo ra từ dữ liệu như văn bản, hình ảnh hay âm thanh. Điều quan trọng là những nội dung có ý nghĩa gần nhau sẽ có vector nằm gần nhau trong không gian.
Ví dụ, câu "cách xin nghỉ phép" và "thủ tục đăng ký ngày nghỉ" không trùng từ nào quan trọng, nhưng embedding của chúng sẽ rất gần nhau. Đây là điều mà tìm kiếm theo từ khóa truyền thống khó làm được.
Vector database là gì?
Vector database là hệ thống được tối ưu để lưu trữ, đánh chỉ mục và truy vấn vector theo độ tương đồng. Thay vì hỏi "tìm bản ghi có id = 42", bạn hỏi "tìm 10 bản ghi có vector gần nhất với vector này".
Độ "gần" thường được đo bằng:
- Cosine similarity: so sánh góc giữa hai vector, phổ biến với embedding văn bản.
- Khoảng cách Euclid (L2): khoảng cách hình học thông thường.
- Tích vô hướng (dot product): hiệu quả khi vector đã được chuẩn hóa.
Vì sao không chỉ dùng vòng lặp so sánh?
Với vài nghìn vector, bạn hoàn toàn có thể so sánh từng cái (brute force) và mọi thứ vẫn nhanh. Nhưng với hàng triệu vector nhiều chiều, cách này trở nên quá chậm. Vector database giải quyết bằng các thuật toán tìm kiếm láng giềng gần đúng (Approximate Nearest Neighbor, ANN), chấp nhận đánh đổi một chút độ chính xác để có tốc độ cao hơn rất nhiều. Hai loại chỉ mục phổ biến:
- HNSW (Hierarchical Navigable Small World): xây đồ thị nhiều tầng, truy vấn nhanh, độ chính xác cao nhưng tốn bộ nhớ.
- IVF (Inverted File): chia vector thành các cụm, chỉ tìm trong những cụm gần nhất.
Ngoài ra, vector database còn cung cấp những tính năng mà một thư viện tìm kiếm thuần túy không có: lọc theo metadata, cập nhật dữ liệu theo thời gian thực, phân quyền, sao lưu và mở rộng quy mô.
Các lựa chọn phổ biến
Có thể chia thành ba nhóm chính:
- Tiện ích cho database sẵn có: pgvector cho PostgreSQL, cùng tính năng tìm kiếm vector trong Elasticsearch, OpenSearch, Redis hay MongoDB Atlas.
- Vector database chuyên dụng mã nguồn mở: Qdrant, Milvus, Weaviate, Chroma.
- Dịch vụ được quản lý hoàn toàn: Pinecone và các phiên bản cloud của những sản phẩm trên.
Ví dụ với pgvector, bạn có thể lưu và truy vấn vector ngay bằng SQL quen thuộc:
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE documents (
  id bigserial PRIMARY KEY,
  content text,
  embedding vector(1536)
);

-- Tìm 5 đoạn gần nhất theo cosine distance
SELECT id, content
FROM documents
ORDER BY embedding <=> $1
LIMIT 5;
Số chiều trong ví dụ phụ thuộc vào mô hình embedding bạn chọn.
Khi nào nên dùng vector database?
Vector database phát huy giá trị trong các bài toán:
- RAG và chatbot hỏi đáp tài liệu: truy xuất đoạn văn liên quan để đưa vào prompt.
- Tìm kiếm ngữ nghĩa: người dùng tìm bằng ngôn ngữ tự nhiên thay vì từ khóa chính xác.
- Hệ thống gợi ý: tìm sản phẩm, bài viết tương tự.
- Tìm ảnh tương tự, phát hiện trùng lặp: so sánh embedding hình ảnh hoặc văn bản.
- Phát hiện bất thường: những điểm nằm xa các cụm thông thường.
Khi nào chưa cần?
Đây là phần nhiều team bỏ qua. Bạn có thể chưa cần một vector database riêng nếu:
- Dữ liệu nhỏ (vài chục nghìn vector): lưu trong PostgreSQL với pgvector, hoặc thậm chí trong bộ nhớ là đủ.
- Bài toán chủ yếu là tìm chính xác theo mã, tên, bộ lọc: full-text search hoặc SQL truyền thống làm tốt hơn.
- Team chưa có kinh nghiệm vận hành thêm một hệ thống mới: mỗi thành phần thêm vào là thêm chi phí giám sát, sao lưu và bảo mật.
Một nguyên tắc thực tế: bắt đầu với công cụ đơn giản nhất mà team đã quen, đo hiệu năng với dữ liệu thật, và chỉ chuyển sang giải pháp chuyên dụng khi gặp giới hạn rõ ràng về tốc độ, quy mô hoặc tính năng.
Lưu ý khi triển khai
- Chọn mô hình embedding cẩn thận: đổi mô hình đồng nghĩa với việc phải tạo lại toàn bộ vector.
- Kết hợp tìm kiếm lai: ghép tìm kiếm vector với tìm kiếm từ khóa thường cho kết quả tốt hơn, đặc biệt với tên riêng và mã số.
- Tận dụng metadata: lọc theo ngày, phòng ban, ngôn ngữ để thu hẹp kết quả và đảm bảo phân quyền.
- Theo dõi chi phí bộ nhớ: vector nhiều chiều với hàng triệu bản ghi tiêu tốn RAM đáng kể, nhất là với HNSW.
Kết luận
Vector database là mảnh ghép quan trọng trong nhiều ứng dụng AI hiện đại, giúp tìm kiếm theo ý nghĩa thay vì từ khóa. Tuy vậy, nó không phải lúc nào cũng cần thiết. Hãy hiểu rõ bài toán, bắt đầu nhỏ với công cụ sẵn có như pgvector, và chỉ đầu tư vào giải pháp chuyên dụng khi quy mô thực sự đòi hỏi.