Hãy tưởng tượng nhân viên mới muốn biết quy trình xin nghỉ phép, chính sách công tác phí hay cách cấu hình môi trường dev của dự án. Thông tin có đủ cả, nhưng nằm rải rác trong hàng trăm file Word, PDF, wiki và trang Confluence. Một chatbot hiểu được tài liệu nội bộ và trả lời đúng trọng tâm là mong muốn của rất nhiều doanh nghiệp. Tuy nhiên, các mô hình ngôn ngữ lớn (LLM) không biết gì về dữ liệu riêng của bạn. Đó là lúc RAG xuất hiện.
RAG là gì?
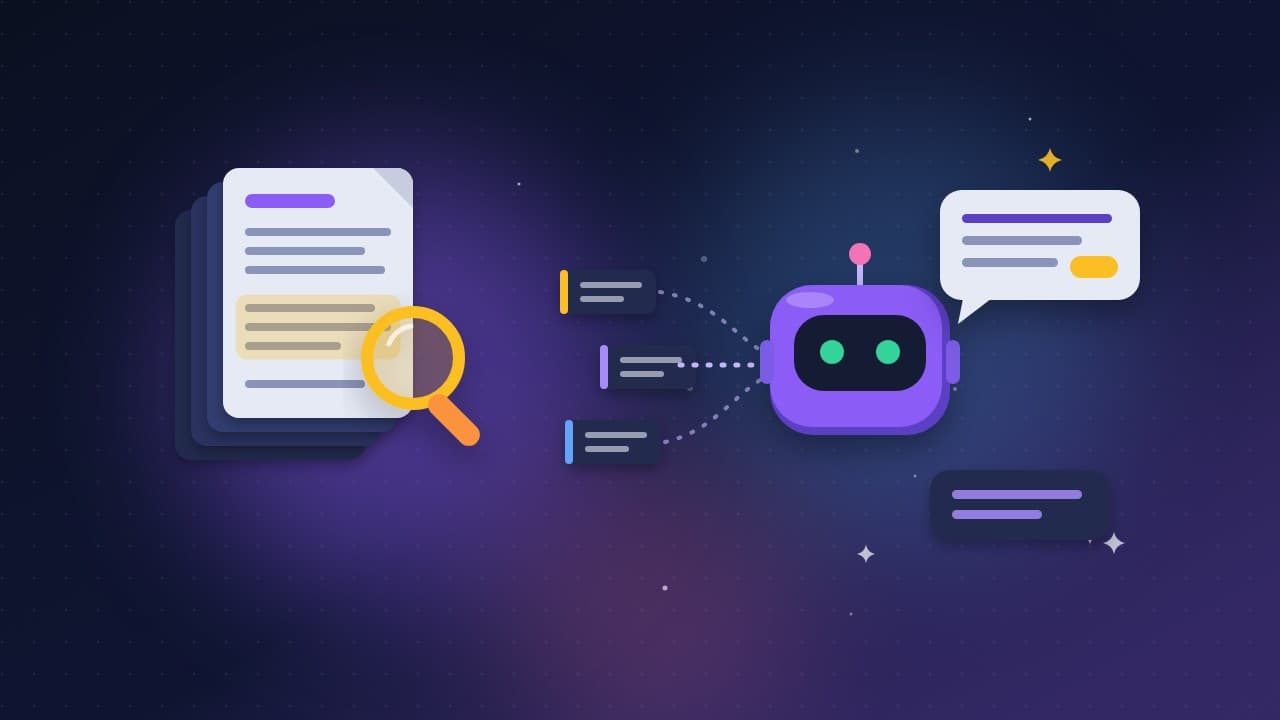
RAG (Retrieval-Augmented Generation) là kỹ thuật kết hợp hai bước: truy xuất (retrieval) những đoạn tài liệu liên quan đến câu hỏi, sau đó sinh câu trả lời (generation) bằng LLM dựa trên chính các đoạn đó. Thuật ngữ này được phổ biến qua bài báo của nhóm nghiên cứu Facebook AI năm 2020, và đến nay đã trở thành kiến trúc phổ biến nhất khi đưa dữ liệu riêng vào ứng dụng AI.
Thay vì để mô hình trả lời từ "trí nhớ" chung chung, RAG giống như cho mô hình một bài thi được mở tài liệu: tìm đúng trang cần thiết, đọc, rồi trả lời.
Vì sao không fine-tune luôn cho nhanh?
Fine-tune (huấn luyện thêm) mô hình trên dữ liệu công ty nghe hấp dẫn, nhưng với bài toán hỏi đáp tài liệu, RAG thường phù hợp hơn vì:
- Dữ liệu luôn cập nhật: tài liệu thay đổi, bạn chỉ cần index lại, không phải huấn luyện lại mô hình.
- Có trích dẫn nguồn: câu trả lời có thể kèm đường dẫn đến tài liệu gốc để người dùng kiểm chứng.
- Giảm "ảo giác": mô hình được yêu cầu chỉ trả lời dựa trên ngữ cảnh đã cung cấp.
- Kiểm soát quyền truy cập: có thể lọc tài liệu theo phòng ban hoặc vai trò trước khi đưa vào prompt.
- Chi phí thấp hơn: không cần GPU và quy trình huấn luyện phức tạp.
Fine-tune vẫn có chỗ đứng, chẳng hạn khi cần mô hình nói đúng giọng văn hoặc định dạng đặc thù, nhưng hai kỹ thuật này có thể kết hợp chứ không loại trừ nhau.
Kiến trúc một hệ thống RAG
Một pipeline RAG cơ bản gồm hai giai đoạn.
Giai đoạn 1: Chuẩn bị dữ liệu (indexing)
- Thu thập tài liệu từ các nguồn như Google Drive, SharePoint, wiki, cơ sở dữ liệu.
- Trích xuất văn bản từ PDF, DOCX, HTML và làm sạch (bỏ header, footer lặp lại).
- Chia nhỏ (chunking) thành các đoạn vài trăm token, thường có phần chồng lấn để không mất ngữ cảnh.
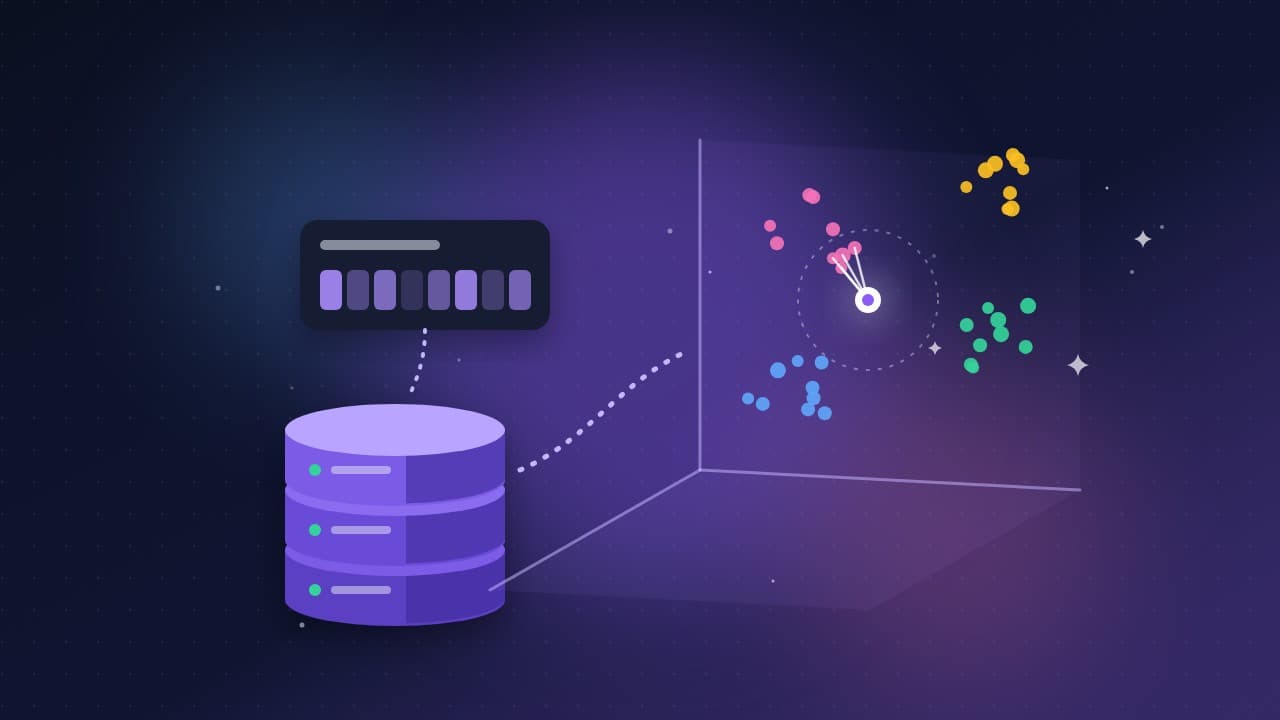
- Tạo embedding cho từng đoạn bằng một mô hình embedding, biến văn bản thành vector số.
- Lưu vào vector database cùng metadata như tên file, ngày cập nhật, quyền truy cập.
Giai đoạn 2: Trả lời câu hỏi (query)
- Người dùng đặt câu hỏi, hệ thống tạo embedding cho câu hỏi đó.
- Tìm các đoạn tài liệu có vector gần nhất trong cơ sở dữ liệu.
- Ghép các đoạn tìm được vào prompt cùng chỉ dẫn.
- LLM sinh câu trả lời và trích dẫn nguồn.
Phần prompt ở bước 3 có thể trông như sau:
Bạn là trợ lý nội bộ của công ty. Chỉ trả lời dựa trên tài liệu
trong thẻ <context>. Nếu không tìm thấy thông tin, hãy nói
"Tôi chưa tìm thấy thông tin này trong tài liệu".
Luôn ghi tên tài liệu nguồn ở cuối câu trả lời.

<context>
{cac_doan_tai_lieu_lien_quan}
</context>

Câu hỏi: {cau_hoi_nguoi_dung}
Công cụ thường dùng
Hệ sinh thái RAG hiện rất phong phú. Bạn có thể dùng framework như LangChain hoặc LlamaIndex để ghép nối các bước; vector database như pgvector (tiện ích cho PostgreSQL), Qdrant, Chroma, Weaviate hay Pinecone; cùng API embedding và LLM từ các nhà cung cấp lớn hoặc mô hình mã nguồn mở tự host. Với dự án nhỏ, bắt đầu bằng PostgreSQL kèm pgvector thường là lựa chọn gọn nhẹ vì team đã quen vận hành.
Những yếu tố quyết định chất lượng
Dựng một bản demo RAG chỉ mất vài giờ, nhưng để chatbot trả lời tốt trong thực tế cần chú ý:
- Chất lượng dữ liệu nguồn: tài liệu lỗi thời hoặc mâu thuẫn sẽ dẫn đến câu trả lời sai. "Rác vào, rác ra" vẫn đúng.
- Chiến lược chunking: chia theo tiêu đề, đoạn văn thường tốt hơn cắt cứng theo số ký tự.
- Tìm kiếm lai (hybrid search): kết hợp tìm theo ngữ nghĩa với tìm theo từ khóa như BM25 giúp xử lý tốt mã sản phẩm, tên riêng, thuật ngữ viết tắt.
- Reranking: dùng mô hình xếp hạng lại để chọn ra những đoạn thực sự liên quan nhất trước khi đưa vào prompt.
- Bổ sung ngữ cảnh cho chunk: Anthropic đã giới thiệu kỹ thuật "contextual retrieval", thêm một câu mô tả ngữ cảnh vào mỗi đoạn trước khi index để giảm lỗi truy xuất.
- Tiếng Việt: hãy chọn mô hình embedding hỗ trợ tốt đa ngôn ngữ và thử nghiệm với câu hỏi thực tế của người dùng.
Đánh giá và vận hành
Đừng chỉ đánh giá bằng cảm tính. Hãy xây một bộ câu hỏi mẫu kèm đáp án đúng, rồi đo cả hai phía: hệ thống có tìm đúng tài liệu không, và câu trả lời có trung thành với tài liệu không. Khi đưa vào sử dụng, ghi log câu hỏi (tuân thủ chính sách bảo mật), thu thập phản hồi "hữu ích / không hữu ích" và định kỳ cập nhật index. Đặc biệt, phải đảm bảo người dùng chỉ nhận được thông tin từ tài liệu họ có quyền xem.
Kết luận
RAG là cách thực tế và tiết kiệm nhất để biến kho tài liệu nội bộ thành trợ lý hỏi đáp thông minh. Hãy bắt đầu nhỏ với một nhóm tài liệu rõ ràng, đo lường chất lượng bằng bộ câu hỏi mẫu, rồi cải tiến dần qua chunking, hybrid search và reranking. Khi làm đúng, chatbot RAG có thể tiết kiệm đáng kể thời gian tra cứu cho cả tổ chức.