Một truy vấn chạy mất vài mili giây khi bảng chỉ có nghìn dòng có thể kéo dài tới hàng chục giây khi dữ liệu lên tới hàng chục triệu bản ghi. Phản xạ đầu tiên của nhiều lập trình viên là "thêm index vào". Cách này thường hiệu quả, nhưng không phải lúc nào cũng đúng. Index là con dao hai lưỡi: nó tăng tốc thao tác đọc nhưng lại tạo thêm chi phí cho thao tác ghi và chiếm dung lượng lưu trữ. Bài viết này giúp bạn hiểu index trong PostgreSQL hoạt động thế nào, khi nào nên tạo và khi nào nên tránh.
Index là gì?
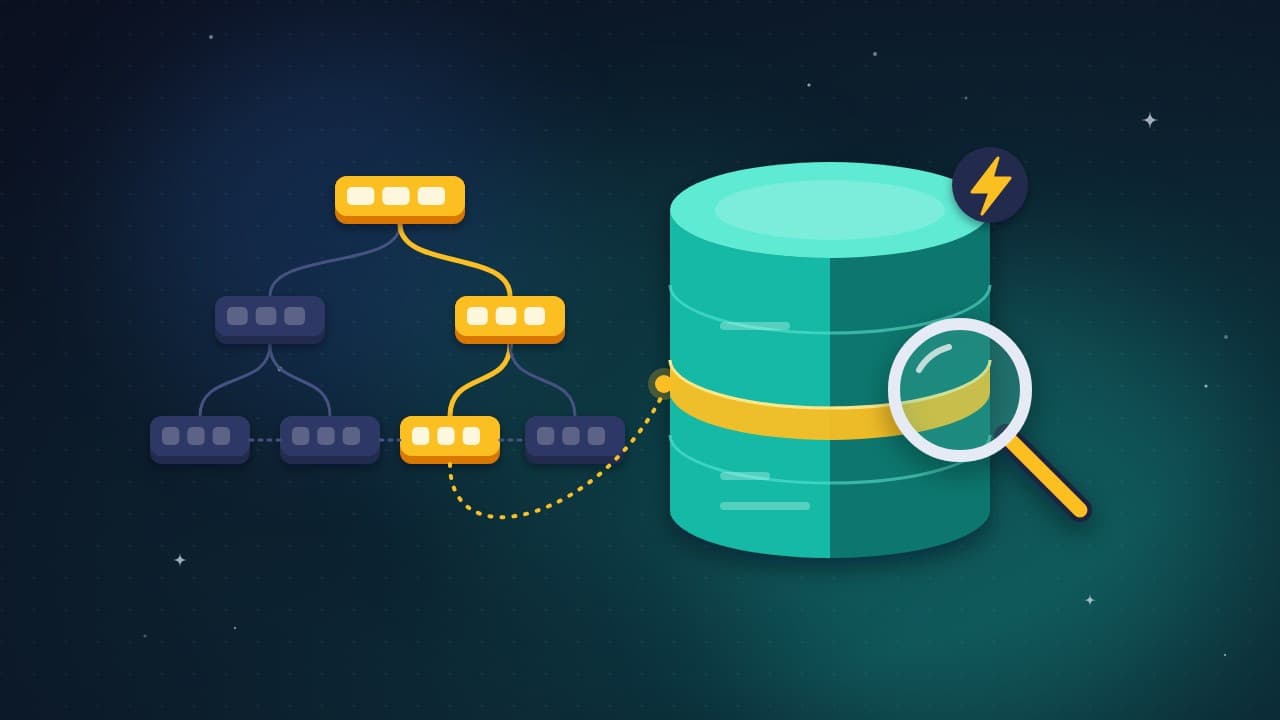
Hãy tưởng tượng một cuốn sách dày không có mục lục. Muốn tìm chương nói về "giao dịch", bạn phải lật từng trang. Index trong cơ sở dữ liệu đóng vai trò như mục lục: một cấu trúc dữ liệu phụ, lưu giá trị của cột cùng vị trí của dòng tương ứng, giúp PostgreSQL đi thẳng tới dữ liệu cần thiết thay vì quét toàn bộ bảng (sequential scan).
CREATE INDEX idx_orders_customer_id ON orders (customer_id);Sau khi tạo, PostgreSQL tự động cập nhật index mỗi khi bảng thay đổi và bộ lập kế hoạch truy vấn (query planner) sẽ tự quyết định có dùng nó hay không.
Các loại index phổ biến
PostgreSQL hỗ trợ nhiều loại index, mỗi loại phù hợp với một kiểu truy vấn:
- B-tree: loại mặc định, phù hợp với so sánh bằng, lớn hơn, nhỏ hơn,
BETWEEN,ORDER BYvàLIKE 'abc%'(tìm theo tiền tố, tuỳ cấu hình collation). - Hash: chỉ dùng cho phép so sánh bằng. Thực tế B-tree thường đủ tốt nên Hash ít được dùng.
- GIN: dành cho dữ liệu chứa nhiều phần tử như mảng,
jsonbhay tìm kiếm toàn văn (full-text search). - GiST và SP-GiST: hỗ trợ dữ liệu hình học, khoảng giá trị, tìm kiếm gần đúng.
- BRIN: cực kỳ nhỏ gọn, hiệu quả với bảng rất lớn mà dữ liệu có thứ tự tự nhiên theo vị trí lưu, ví dụ bảng log sắp theo thời gian.
Khi nào index thực sự tăng tốc?
Index phát huy tác dụng rõ nhất trong các trường hợp sau:
- Cột xuất hiện thường xuyên trong
WHEREvà lọc ra một tỷ lệ nhỏ số dòng, ví dụ tìm người dùng theo email. - Cột dùng để
JOIN, đặc biệt là khoá ngoại. PostgreSQL tự tạo index cho khoá chính và ràng buộcUNIQUE, nhưng không tự tạo cho khoá ngoại. - Truy vấn có
ORDER BY ... LIMIT: index B-tree đã được sắp xếp sẵn nên PostgreSQL có thể đọc vài dòng đầu mà không cần sắp xếp toàn bộ. - Cột có độ chọn lọc cao (nhiều giá trị khác nhau), như mã đơn hàng hay số điện thoại.
Index nhiều cột và thứ tự cột
Với truy vấn lọc theo nhiều cột, bạn có thể tạo index kết hợp:
CREATE INDEX idx_orders_customer_created
  ON orders (customer_id, created_at DESC);
Thứ tự cột rất quan trọng. Index trên (customer_id, created_at) hoạt động hiệu quả nhất khi truy vấn có điều kiện trên cột đầu tiên customer_id. Nếu bạn chỉ lọc theo created_at, index này thường không giúp được nhiều.
Partial index và expression index
Hai kỹ thuật giúp index nhỏ và "trúng đích" hơn:
-- Chỉ đánh index các đơn chưa xử lý
CREATE INDEX idx_orders_pending ON orders (created_at)
  WHERE status = 'pending';

-- Đánh index theo biểu thức để tìm email không phân biệt hoa thường
CREATE INDEX idx_users_email_lower ON users (lower(email));
Lưu ý: expression index chỉ được dùng khi truy vấn viết đúng biểu thức đó, ví dụ WHERE lower(email) = 'a@b.com'.
Khi nào index làm chậm hệ thống?
Đây là phần thường bị bỏ qua:
- Chi phí ghi tăng lên: mỗi lệnh
INSERT,UPDATE,DELETEphải cập nhật cả bảng lẫn mọi index liên quan. Bảng có quá nhiều index sẽ ghi chậm đáng kể, nhất là với hệ thống ghi nhiều như log hay sự kiện. - Tốn dung lượng và bộ nhớ đệm: index chiếm chỗ trên đĩa và cạnh tranh với dữ liệu thật trong shared buffers.
- Cột có độ chọn lọc thấp: index trên cột kiểu boolean hay trạng thái chỉ có vài giá trị thường vô ích, vì PostgreSQL vẫn phải đọc phần lớn bảng. Planner có thể tự bỏ qua, nhưng index vẫn tốn chi phí duy trì.
- Index trùng lặp hoặc không bao giờ được dùng: ví dụ đã có index
(a, b)lại tạo thêm index(a). - Truy vấn vô tình vô hiệu hoá index: bọc cột trong hàm (
WHERE date(created_at) = ...), tìm kiếmLIKE '%abc'với ký tự đại diện ở đầu, hoặc so sánh khác kiểu dữ liệu.
Đo lường thay vì đoán
Nguyên tắc vàng: đừng tạo index theo cảm tính. Hãy dùng EXPLAIN ANALYZE để xem PostgreSQL thực sự thực thi truy vấn thế nào:
EXPLAIN ANALYZE
SELECT * FROM orders
WHERE customer_id = 42
ORDER BY created_at DESC
LIMIT 20;
Hãy chú ý các dòng như Seq Scan, Index Scan, Bitmap Heap Scan cùng thời gian thực thi. Nếu thấy Seq Scan trên bảng lớn mà điều kiện lọc rất hẹp, đó là dấu hiệu nên cân nhắc index.
Để tìm index không được sử dụng, bạn có thể truy vấn view thống kê pg_stat_user_indexes và xem cột idx_scan. Index có giá trị bằng 0 sau một thời gian dài vận hành là ứng viên để xem xét xoá.
Mẹo khi tạo index trên production
- Dùng
CREATE INDEX CONCURRENTLYđể tránh khoá ghi trên bảng trong lúc tạo index. Đổi lại, quá trình sẽ lâu hơn và không chạy được bên trong transaction. - Chạy
ANALYZEsau khi nạp lượng lớn dữ liệu để planner có thống kê chính xác. - Xem lại index định kỳ khi mẫu truy vấn của ứng dụng thay đổi.
Kết luận
Index là công cụ tối ưu hiệu năng mạnh mẽ nhất trong PostgreSQL, nhưng chỉ khi được dùng có chủ đích. Hãy tạo index cho các cột lọc, join và sắp xếp thường xuyên với độ chọn lọc cao; tận dụng index nhiều cột, partial index và expression index để index nhỏ gọn; và luôn kiểm chứng bằng EXPLAIN ANALYZE. Đồng thời, đừng quên rằng mỗi index đều có cái giá phải trả cho thao tác ghi. Một bộ index tốt không phải là nhiều nhất, mà là vừa đủ.