Hai đoạn code cùng cho ra kết quả đúng, chạy thử trên máy bạn đều mất chưa tới một giây. Nhưng khi đưa lên môi trường thật với hàng triệu bản ghi, một đoạn vẫn chạy mượt, đoạn kia khiến cả hệ thống treo. Sự khác biệt đó nằm ở độ phức tạp thuật toán, và Big O là "ngôn ngữ chung" để lập trình viên mô tả nó. Bài viết này giải thích Big O một cách dễ hiểu và giới thiệu những cấu trúc dữ liệu cơ bản mà ai cũng nên nắm.
Big O là gì?
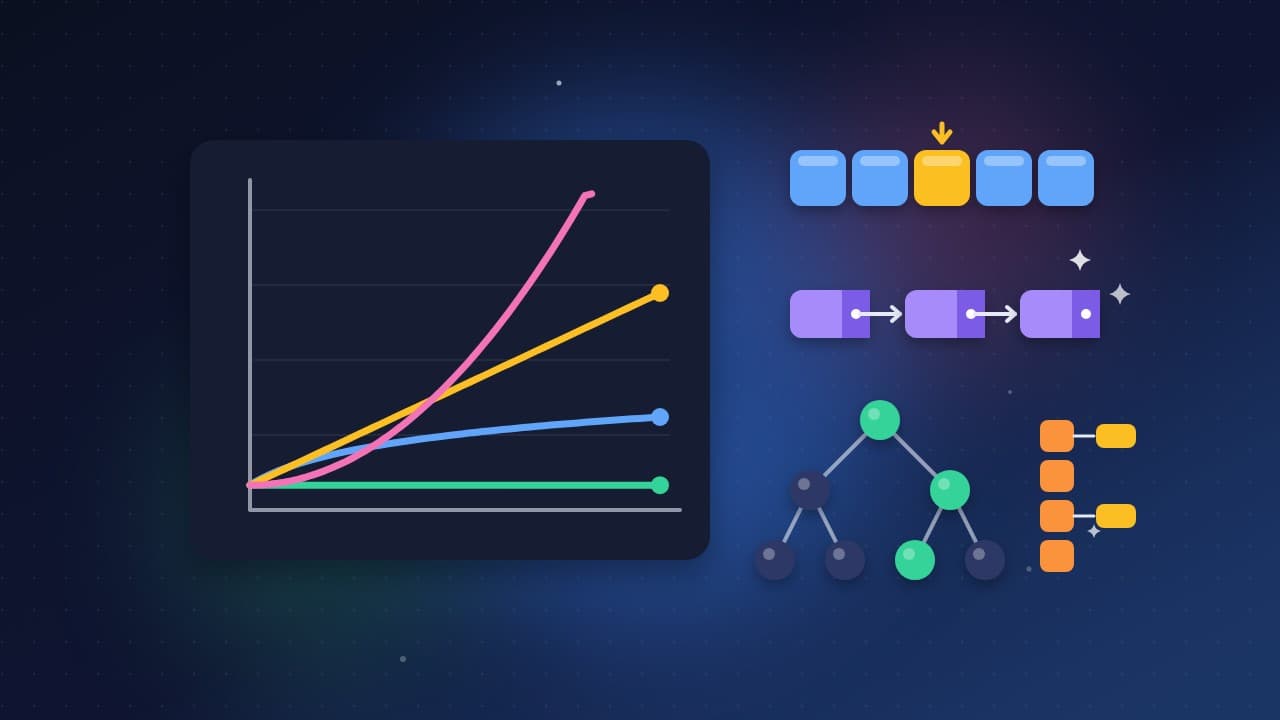
Big O mô tả thời gian chạy (hoặc bộ nhớ) tăng lên như thế nào khi kích thước dữ liệu đầu vào n tăng lên. Nó không đo số giây cụ thể, vì điều đó phụ thuộc vào máy tính, ngôn ngữ. Thay vào đó, Big O quan tâm đến xu hướng tăng trưởng trong trường hợp xấu nhất.
Khi tính Big O, ta bỏ qua hằng số và các thành phần nhỏ hơn. Ví dụ, một thuật toán thực hiện 3n + 5 bước được viết là O(n), vì khi n rất lớn, 3 và 5 không còn ý nghĩa đáng kể.
Các mức độ phức tạp thường gặp
Sắp xếp từ nhanh đến chậm:
- O(1) – hằng số: thời gian không đổi dù dữ liệu lớn bao nhiêu. Ví dụ: truy cập phần tử mảng theo chỉ số.
- O(log n) – logarit: mỗi bước loại bỏ một nửa dữ liệu. Ví dụ: tìm kiếm nhị phân trên mảng đã sắp xếp.
- O(n) – tuyến tính: duyệt qua mỗi phần tử một lần. Ví dụ: tìm giá trị lớn nhất trong mảng chưa sắp xếp.
- O(n log n): mức điển hình của các thuật toán sắp xếp hiệu quả như merge sort.
- O(n²) – bình phương: thường xuất hiện khi có hai vòng lặp lồng nhau trên cùng dữ liệu.
- O(2ⁿ) – hàm mũ: tăng cực nhanh, ví dụ tính Fibonacci đệ quy ngây thơ.
Để cảm nhận sự khác biệt: với n = 1.000.000, thuật toán O(log n) chỉ cần khoảng 20 bước, O(n) cần một triệu bước, còn O(n²) cần tới một nghìn tỷ bước.
Ví dụ thực tế: kiểm tra phần tử trùng lặp
Cách tiếp cận ngây thơ so sánh từng cặp phần tử:
def has_duplicate_slow(items):        # O(n²)
    for i in range(len(items)):
        for j in range(i + 1, len(items)):
            if items[i] == items[j]:
                return True
    return False

def has_duplicate_fast(items):        # O(n)
    seen = set()
    for item in items:
        if item in seen:
            return True
        seen.add(item)
    return False
Phiên bản thứ hai dùng set, nơi thao tác kiểm tra tồn tại có độ phức tạp trung bình O(1). Chỉ cần chọn đúng cấu trúc dữ liệu, thuật toán từ O(n²) đã trở thành O(n), đổi lại tốn thêm bộ nhớ O(n). Đây chính là sự đánh đổi giữa thời gian và bộ nhớ mà bạn sẽ gặp thường xuyên.
Các cấu trúc dữ liệu cơ bản
Mảng (Array) và danh sách động
Lưu phần tử liên tiếp trong bộ nhớ. Truy cập theo chỉ số là O(1), thêm vào cuối thường là O(1) (trung bình), nhưng chèn hoặc xóa ở đầu, giữa là O(n) vì phải dịch chuyển các phần tử. Tìm kiếm một giá trị trong mảng chưa sắp xếp là O(n). Trong Python, list là một mảng động.
Danh sách liên kết (Linked List)
Mỗi nút chứa dữ liệu và con trỏ đến nút tiếp theo. Chèn, xóa tại vị trí đã biết là O(1), nhưng truy cập phần tử thứ k là O(n) vì phải đi lần lượt từ đầu.
Ngăn xếp (Stack) và Hàng đợi (Queue)
- Stack hoạt động theo nguyên tắc LIFO (vào sau, ra trước), dùng cho chức năng undo, gọi hàm đệ quy, kiểm tra dấu ngoặc.
- Queue theo nguyên tắc FIFO (vào trước, ra trước), dùng cho hàng đợi xử lý tác vụ, duyệt đồ thị theo chiều rộng (BFS).
Cả hai đều có thao tác thêm và lấy với độ phức tạp O(1) nếu cài đặt đúng. Trong Python, nên dùng collections.deque cho hàng đợi thay vì list.pop(0) vốn là O(n).
Bảng băm (Hash Table)
Ánh xạ khóa đến giá trị qua hàm băm. Thêm, xóa, tìm kiếm trung bình đều O(1), trường hợp xấu có thể lên O(n) khi nhiều khóa va chạm. dict và set trong Python, Map và Set trong JavaScript đều dựa trên ý tưởng này. Đây có lẽ là cấu trúc hữu ích nhất trong công việc hằng ngày.
Cây (Tree) và Cây nhị phân tìm kiếm
Cây nhị phân tìm kiếm (BST) giữ thứ tự: nút con trái nhỏ hơn, nút con phải lớn hơn. Nếu cây cân bằng, tìm kiếm, thêm, xóa đều O(log n). Nếu cây lệch hẳn về một phía, nó suy biến thành danh sách liên kết với O(n). Các biến thể cây cân bằng và B-tree được dùng rộng rãi trong chỉ mục cơ sở dữ liệu.
Heap
Cây đặc biệt luôn giữ phần tử nhỏ nhất (hoặc lớn nhất) ở gốc. Lấy phần tử nhỏ nhất là O(1), thêm hoặc xóa là O(log n). Heap là nền tảng của hàng đợi ưu tiên, ví dụ module heapq trong Python.
Đồ thị (Graph)
Tập hợp đỉnh và cạnh, dùng để mô hình hóa mạng xã hội, bản đồ đường đi, quan hệ phụ thuộc giữa các module. Hai cách duyệt cơ bản là BFS và DFS.
Lời khuyên khi áp dụng
- Đừng tối ưu quá sớm: với dữ liệu nhỏ, code dễ đọc quan trọng hơn. Hãy đo bằng công cụ profiling trước khi tối ưu.
- Để ý vòng lặp lồng nhau và các lời gọi ẩn bên trong vòng lặp, như
intrênlisthay truy vấn database trong vòng lặp. - Tra cứu độ phức tạp của các thao tác trong ngôn ngữ bạn dùng; trang wiki của Python có bảng tổng hợp chi tiết.
Kết luận
Big O không chỉ là chủ đề cho phỏng vấn mà là công cụ tư duy giúp bạn viết code có khả năng mở rộng. Nắm vững các mức độ phức tạp phổ biến và đặc điểm của từng cấu trúc dữ liệu, bạn sẽ biết chọn đúng công cụ cho từng bài toán, và thường chỉ một thay đổi nhỏ như dùng set thay list đã tạo ra khác biệt lớn.